這臺採用NVIDIA RTX Spark N1X,不是常見的獨立顯示卡筆記本:晶片把20核Grace CPU和6144核Blackwell RTX GPU整合在一起,支援CUDA,FP4 AI算力標稱最高1 Petaflop。效能方向更偏本地AI推理、Adobe渲染和3D渲染;4K剪輯也有硬體加速潛力,但實際表現要看軟體適配、功耗與散熱,不能只憑核心數推斷幀率。
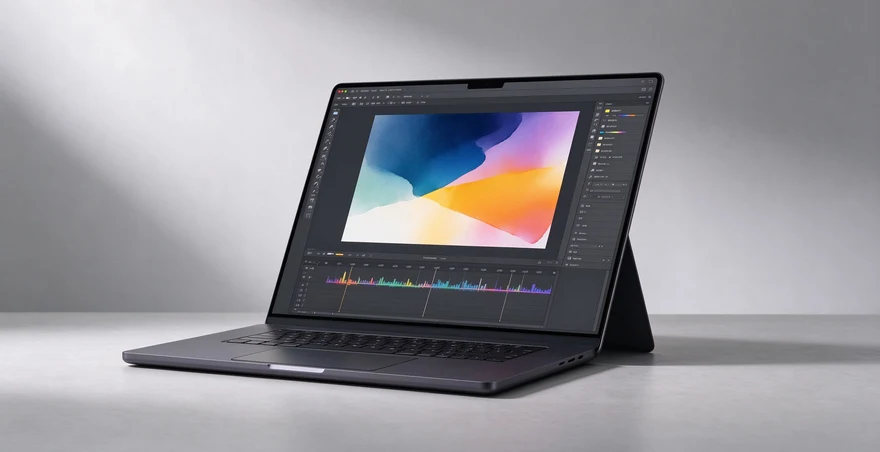
關鍵要點
- Blackwell RTX,6144個CUDA核心。
- Grace+GPU通過NVLink-C2C互連。
- FP4算力1 Petaflop,本地AI。
- 64GB或128GB統一記憶體。
- OLED 165Hz,92.5Wh。
YOGA Pro 15 RTX Spark顯示卡與效能
先抓重點:它的圖形核心是Blackwell RTX,整合在NVIDIA RTX Spark N1X超級晶片裡,而非可單獨更換的傳統獨顯。20核Grace CPU、6144核GPU與NVLink-C2C組成異構計算平台,統一記憶體最高128GB,標稱FP4 AI算力1 Petaflop。適合關注CUDA生態、本地AI推理和創作加速的使用者。至於遊戲表現、持續渲染速度,仍要等具體軟體和整機實測,不能把理論算力直接換算成幀數。
顯示卡架構
Blackwell RTX是這套平台的圖形與平行計算核心,內建6144個CUDA核心,並通過NVLink-C2C與Grace CPU高速互連。與CPU、顯示卡各自使用獨立記憶體的常見筆記本不同,它採用統一記憶體,減少資料在不同記憶體池間搬運的需求。Blackwell架構的Tensor Core面向AI矩陣運算,FP4則是低精度計算格式,能服務支援該精度的模型工作負載。這裡的關鍵是軟硬體協同:應用是否呼叫CUDA、Tensor Core和相應精度,決定效能能否真正落地。
創作效能
在創作環節,CUDA生態為不少渲染、視訊和影象軟體提供GPU加速路徑,適配充分時,Adobe渲染、特效處理和3D渲染可以減少等待;4K剪輯也能受益於平行計算與大容量統一記憶體。尤其當專案同時開啟高解析度素材、多個圖層和複雜外掛時,記憶體空間會影響工作流是否順暢。不過,編碼格式、軟體版本、散熱和整機功耗都會改變實際結果。15.3英寸OLED 165Hz屏更適合看畫面和時間線,但螢幕重新整理率本身不代表渲染速度。
AI算力
這臺更突出的用途是本地AI推理:最高1 Petaflop的FP4算力瞄準低精度AI計算,Blackwell RTX的Tensor Core與CUDA軟體棧則提供模型執行和開發基礎。64GB或128GB統一記憶體可讓CPU、GPU共享更大的資料空間,對載入模型、提示詞處理和並行任務有幫助。需要留意,模型能否執行還與框架、量化格式、上下文長度和記憶體佔用有關;標稱算力不等於所有模型都會達到同等速度。
常見問題
YOGA Pro 15 RTX Spark用什麼顯示卡
採用NVIDIA RTX Spark N1X平台,內含6144核Blackwell RTX GPU,並支援CUDA。它與Grace CPU整合在一顆超級晶片中,通過NVLink-C2C協同,搭配統一記憶體;不應簡單按傳統獨立顯示卡型號來理解。
YOGA Pro 15 RTX Spark能玩遊戲嗎
平台面向圖形計算,也有運行遊戲的可能,但具體體驗要看遊戲相容、驅動、功耗和畫質設定。尤其這是Grace架構與Windows環境的組合,購買前應關注目標遊戲和反作弊元件適配情況。
YOGA Pro 15 RTX Spark能跑本地大模型嗎
定位包含本地AI推理,最高128GB統一記憶體和FP4算力對模型執行有吸引力。能否載入某個模型,取決於模型尺寸、量化方式、上下文長度及推理框架相容情況。建議先查常用工具對CUDA、Blackwell的支援。
YOGA Pro 15 RTX Spark和RTX 4090比
不能只看6144個核心就直接判定勝負:移動版RTX 4090與Blackwell RTX在架構、功耗、視訊記憶體配置和工作負載上都有差異。它的特點是Grace CPU、GPU、NVLink-C2C和統一記憶體整合,AI與本地推理是重點。
參考資料
本文未引用第三方使用者評價,僅基於官網公開引數分析
本文由 Gouwu3 編輯部基於公開資訊整理,僅供參考。